Teknologi CluSTER Pangkas Waktu Pelatihan Model AI hingga 70 Persen
Riset KAIST membuktikan pemilihan data selektif mampu memangkas durasi fine-tuning AI dari sepuluh jam menjadi tiga jam dengan performa yang hampir sama.
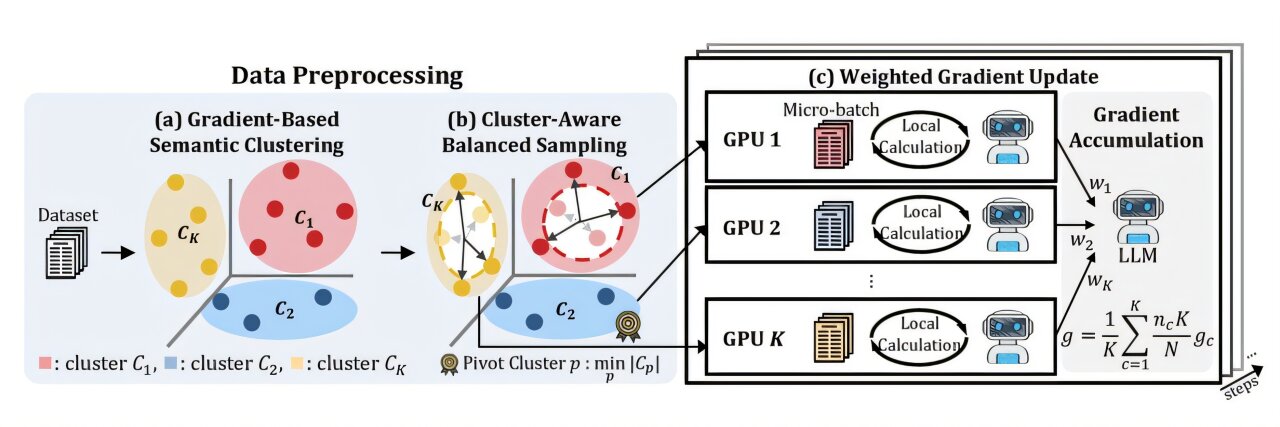
Foto: TechXplore (Dokumentasi editorial)
Poin penting
- Teknologi CluSTER dari KAIST memangkas waktu penyesuaian model AI hingga 69,6 persen.
- Model AI mempertahankan performa hampir serupa walau hanya memakai sekitar 31 persen dataset awal.
- Metode seleksi data berbasis dampak belajar ini berpotensi memangkas biaya sewa GPU korporasi.
Proses melatih ulang model kecerdasan buatan sering kali memakan biaya komputasi yang sangat mahal. Namun, tim peneliti dari Korea Advanced Institute of Science and Technology (KAIST) berhasil menemukan cara memangkas durasi pelatihan model bahasa besar hingga 69,6 persen.
Menurut laporan TechXplore, teknologi bernama CluSTER ini mampu mempersingkat pelatihan yang sebelumnya butuh 10 jam menjadi sekitar tiga jam saja. Riset ini dipimpin oleh Profesor Jae-Gil Lee bersama mahasiswa doktoral Hyunjin Kim dari KAIST School of Computing.
Menghilangkan Redundansi Pembelajaran pada GPU
Sebelum digunakan untuk kebutuhan khusus seperti medis atau pemrograman, model bahasa besar perlu melewati proses penyesuaian khusus atau fine-tuning. Proses ini membutuhkan unit pengolah grafis atau GPU, chip semikonduktor berkecepatan tinggi yang memproses komputasi secara paralel.
Jika data dibagikan secara acak ke berbagai unit pemrosesan, banyak GPU memproses materi serupa secara berulang. CluSTER mengatasi inefisiensi ini dengan menganalisis dampak setiap data terhadap kemampuan model, lalu mengelompokkan materi yang memberi manfaat belajar setara.
Untuk meningkatkan efisiensi pelatihan AI, penting untuk tidak sekadar menambah GPU, melainkan memilih data secara cerdas.
Dalam laporannya di konferensi EMNLP 2026, para peneliti menguji model berukuran 7 miliar dan 13 miliar parameter. Mereka menemukan bahwa model berhasil mempertahankan performa yang hampir sama pada delapan tolok ukur pengujian, meski hanya dilatih menggunakan sekitar 31 persen dari total data awal.
Apa Artinya bagi Pelaku Usaha
Temuan ini menjadi peluang besar bagi pemimpin perusahaan dan manajer teknologi yang ingin membangun model AI privat. Potensi penghematan biaya sewa server GPU dan tagihan komputasi awan kini makin terbuka tanpa harus mengorbankan kualitas keluaran sistem cerdas Anda.
Pelaku usaha di Indonesia disarankan mulai mengevaluasi ulang strategi kurasi data sebelum menambah alokasi sewa mesin komputasi. Mengaudit dan membuang duplikasi konteks dalam data internal dapat menekan durasi pelatihan dan biaya operasional secara nyata.
Untuk implementasi praktis, tim teknis internal dapat mengadopsi pendekatan pengelompokan serupa saat menyiapkan data spesifik industri. Langkah ini membantu mempercepat peluncuran asisten digital atau layanan otomatisasi pelanggan ke pasar dengan risiko pembengkakan anggaran yang lebih terkendali.
- TechXplore: Targeted data selection could roughly triple AI fine-tuning speed
Lihat hasil pemeriksaan (7 klaim)
| Klaim | Putusan | Dasar di sumber |
|---|---|---|
| Teknologi CluSTER dari KAIST memangkas waktu pelatihan model AI hingga hampir 70% (69,6%). | Didukung | “the method shortened training time by up to 69.6% while maintaining nearly the same AI performance.” TechXplore |
| Metode ini mampu memangkas durasi pelatihan dari 10 jam menjadi sekitar 3 jam. | Didukung | “Applying the maximum reduction rate, training that previously took 10 hours could be completed in about three hours.” TechXplore |
| Model mempertahankan performa hampir serupa meski hanya menggunakan sekitar 31% dari total data awal. | Didukung | “the models maintained nearly the same performance even when trained on only about 31% of the full data set” TechXplore |
| Riset dipimpin oleh Profesor Jae-Gil Lee bersama mahasiswa doktoral Hyunjin Kim dari KAIST School of Computing. | Didukung | “A research team led by professor Jae-Gil Lee from the School of Computing developed "CluSTER,"” TechXplore |
| Temuan riset dipresentasikan pada konferensi EMNLP 2026. | Didukung | “The research findings were presented in October 2026 at the Conference on Empirical Methods in Natural Language Processing (EMNLP 2026)” TechXplore |
| Peneliti menguji model bahasa besar berukuran 7 miliar dan 13 miliar parameter pada delapan tolok ukur pengujian. | Didukung | “fine-tuned large language models with approximately 7 billion and 13 billion parameters using three training data sets” TechXplore |
| Kutipan Lee: Untuk meningkatkan efisiensi pelatihan AI, penting untuk tidak sekadar menambah GPU, melainkan memilih data secara cerdas. | Didukung | “To improve the efficiency of AI training, it is important not only to use more GPUs but also to intelligently select which data should be used for learning” TechXplore |
Video AI terbaru
Your Spark, Your Story: Yannik Marek | NVIDIA RTX Spark