Dharma Rilis Field Extractor: AI Ringkas Pengubah Dokumen ke JSON
Dharma-AI mengklaim model AI 2 miliar parameternya mampu mengekstrak dokumen ke JSON terstruktur dengan akurasi melampaui model frontier dan biaya hingga 147 kali lebih hemat.
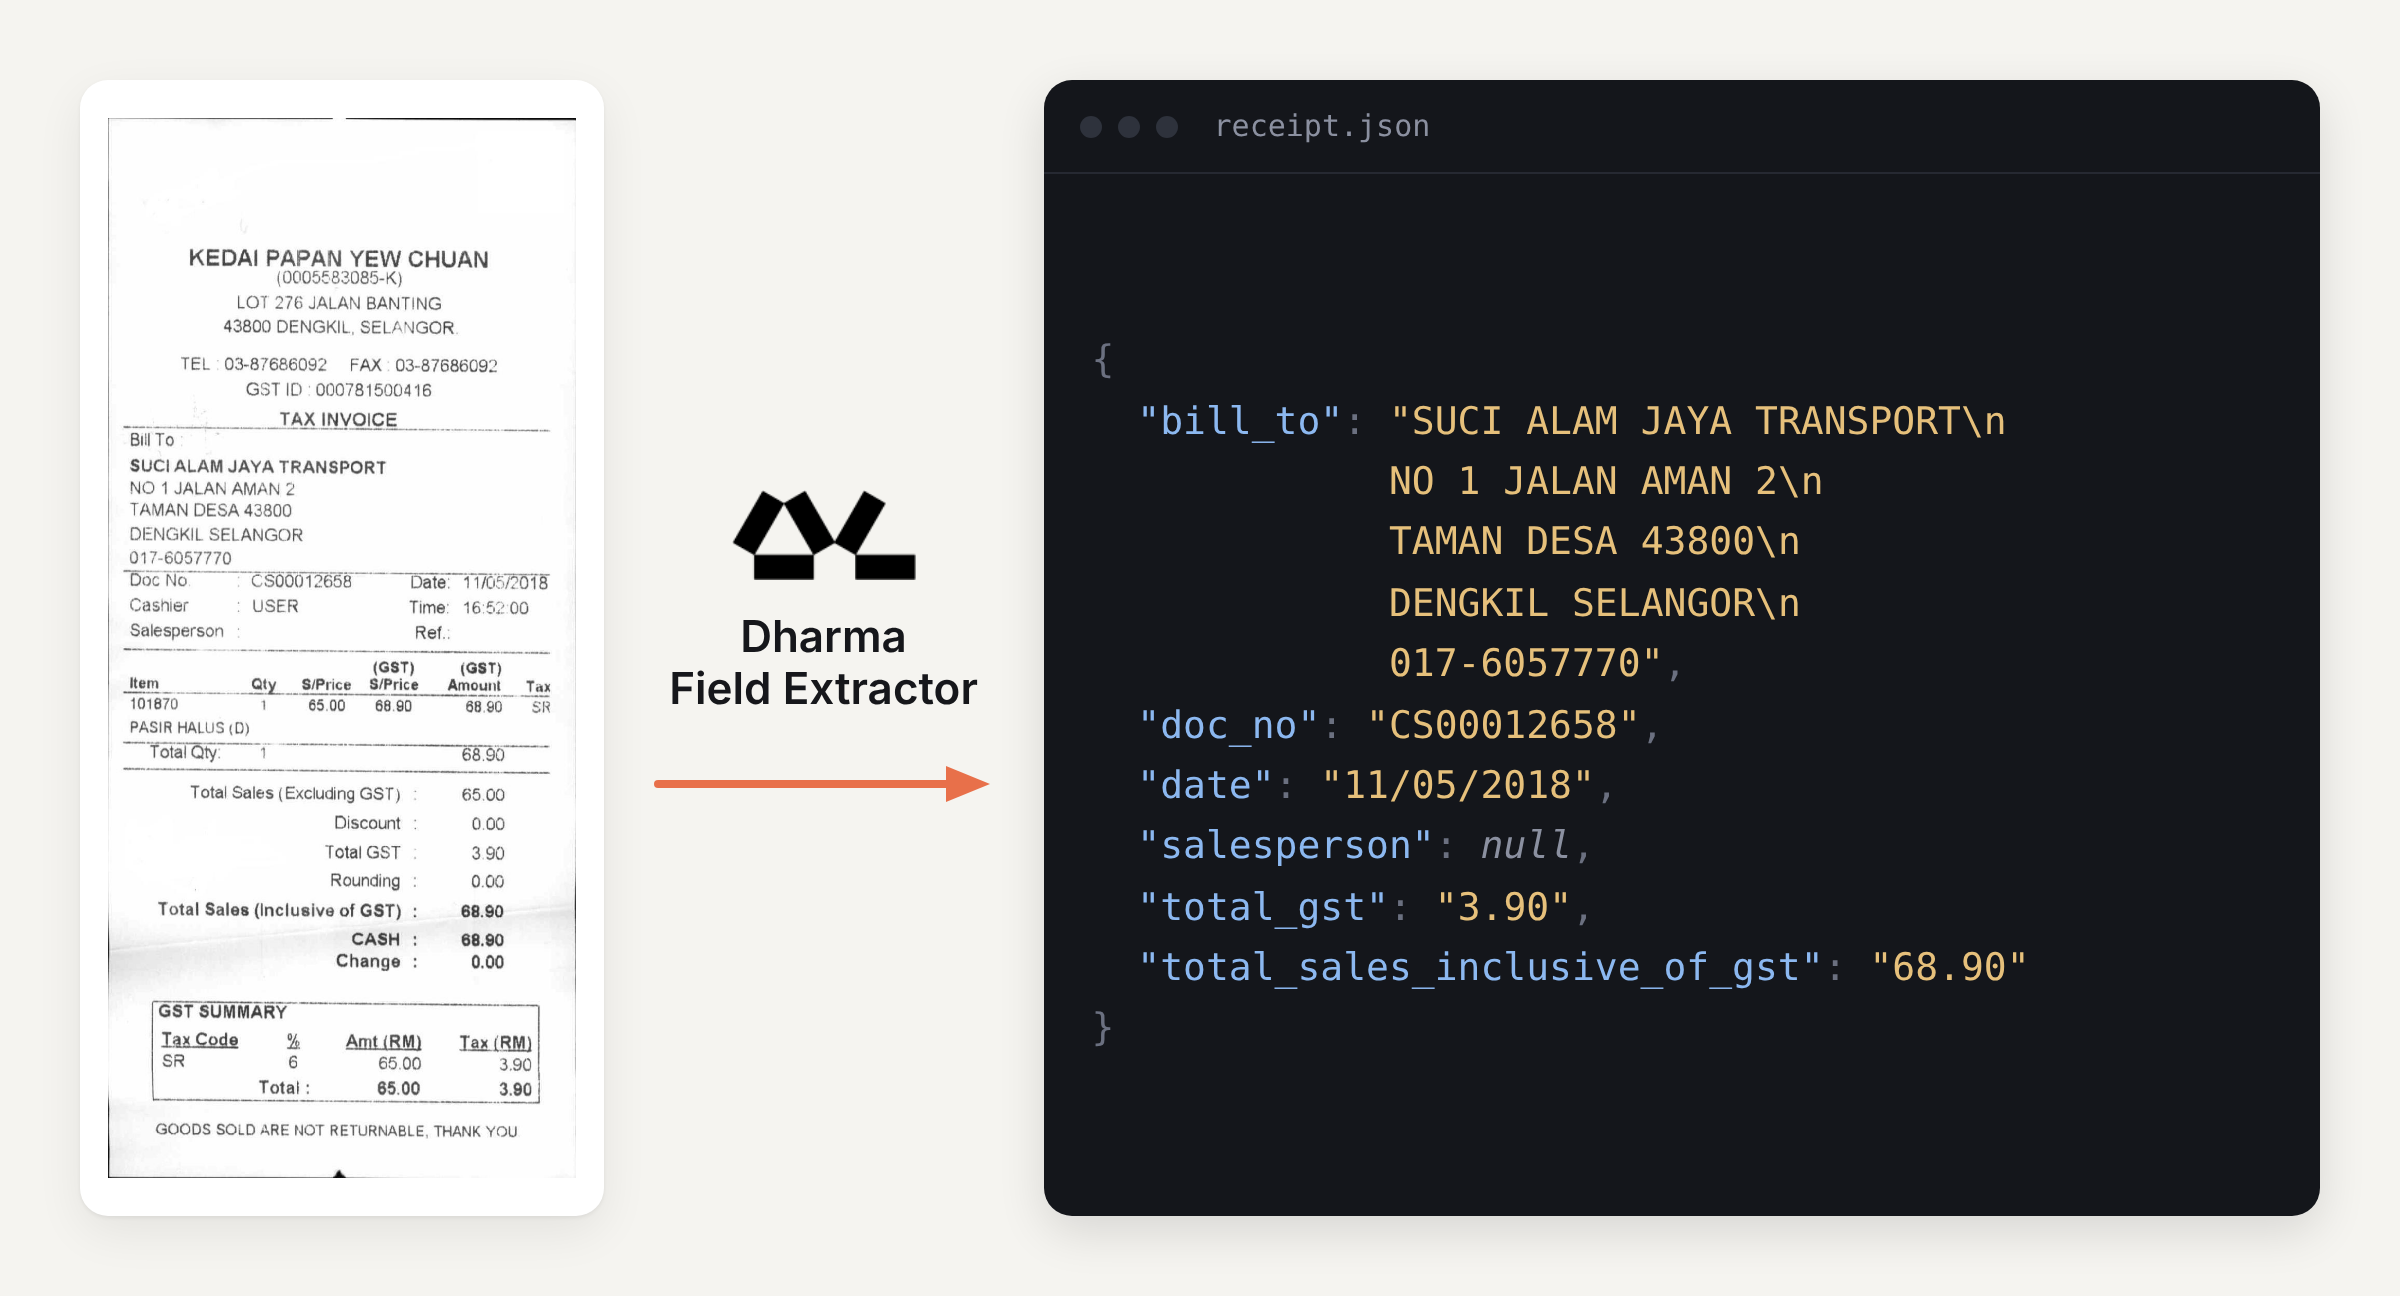
Foto: Hugging Face Blog (Dokumentasi editorial)
Poin penting
- Dharma Field Extractor berbobot 2 miliar parameter mampu mengubah gambar dokumen menjadi data JSON rapi.
- Berdasarkan uji tolok ukur internal pengembang, skor akurasinya 0,834, melampaui Claude Opus 5 dan GPT-5.6.
- Biaya operasional mandiri di server GPU L40S tercatat 6 hingga 147 kali lebih murah dibanding API komersial.
Mengolah ribuan tumpukan faktur, tanda pengenal, dan dokumen klaim secara manual kerap menguras anggaran operasional perusahaan. Layanan kecerdasan buatan teranyar kini menawarkan pemangkasan biaya drastis melalui sistem pemrosesan dokumen yang lebih terarah.
Dharma-AI meluncurkan Dharma Field Extractor, model kecerdasan buatan khusus berukuran 2 miliar parameter. Mengutip laporan resmi di Hugging Face Blog pada Rabu (4/11/2026), perangkat lunak ini dirancang langsung mengubah gambar dokumen menjadi format data terstruktur JSON tanpa memerlukan penulisan kode pemetaan manual tambahan.
Kombinasi Akurasi Tinggi dan Efisiensi Infrastruktur
Teknologi OCR tradisional umumnya sekadar menyalin tulisan dari halaman fisik tanpa memahami fungsi tiap baris kata. Akibatnya, tim pengembang perangkat lunak masih harus menyortir data tersebut secara rumit sebelum diinput ke basis data perusahaan.
Dharma Field Extractor menyelesaikan kendala tersebut dengan memanfaatkan fondasi DharmaOCR-LITE v1.1 yang diperkuat metode LoRA. Pelatihan model ini memakai 43.384 contoh data dokumen lintas sektor, mulai dari kuitansi, faktur komersial, formulir, rekening bank, kartu identitas, hingga dokumen sintetis.
Berdasarkan uji tolok ukur internal pengembang pada 546 dokumen uji, model ini mencetak skor akurasi 0,834. Nilai performa tersebut dilaporkan mengungguli model frontier berukuran raksasa seperti Claude Opus 5 yang meraih skor 0,816 serta GPT-5.6 Luna dengan capaian 0,741.
Parameter count sets the ceiling; training decides how much of it a model reaches on your task. Your business doesn't need the biggest model available. It needs one trained for your problem.
Dari sisi finansial, model ini dirancang untuk berjalan mandiri di infrastruktur server internal (self-hosted). Menggunakan satu unit kartu grafis L40S berbiaya sewa 2,24 dolar AS per jam, pengembang mengklaim biaya pemrosesannya 6 hingga 147 kali lebih terjangkau daripada API komersial pihak ketiga.
Apa Artinya bagi Pelaku Usaha
Inovasi ini sangat relevan bagi direktur operasional, manajer keuangan, serta pimpinan logistik di Indonesia yang rutin memproses dokumen berulang bervolume tinggi. Ketergantungan pada API kecerdasan buatan umum berskala besar sering kali membebani arus kas perusahaan karena skema tarif per token yang mahal.
Pelaku usaha kini dapat beralih menguji model bahasa kecil spesifik (small language model) untuk mengotomasi alur faktur dan verifikasi pelanggan. Pendekatan instalasi mandiri di server lokal juga menjaga keamanan data transaksi sensitif agar tidak bocor ke peladen penyedia cloud publik luar negeri.
Langkah awal praktis yang dapat diambil adalah memetakan skema format keluaran data JSON yang dibutuhkan sistem ERP perusahaan Anda. Lakukan uji coba perbandingan akurasi pada dokumen lokal berbahasa Indonesia sebelum memutuskan migrasi total dari sistem entri manual.
- Hugging Face Blog: Dharma Field Extractor: Any Document In, Structured Fields in JSON Out
Lihat hasil pemeriksaan (10 klaim)
| Klaim | Putusan | Dasar di sumber |
|---|---|---|
| Dharma merilis Field Extractor sebagai model AI untuk mengubah dokumen menjadi data JSON. | Didukung | “The Field Extractor takes a document image and either a request for everything it can find, or an exact schema to fill, and returns structured JSON” Hugging Face Blog menyatakan Field Extractor menerima gambar dokumen dan menghasilkan JSON terstruktur. |
| Dharma Field Extractor memiliki ukuran model 2 miliar parameter. | Didukung | “A 2-billion-parameter model that extracts exactly the fields you ask for, from any document type” Hugging Face Blog menyebutkan model ini memiliki 2 miliar parameter. |
| Dharma-AI mengklaim model 2 miliar parameternya mampu mengekstrak dokumen ke JSON terstruktur dengan akurasi melampaui model frontier dan biaya hingga 147 kali lebih hemat. | Didukung | “outperforming every frontier LLM we tested, at a fraction of the cost.” Hugging Face Blog mencatat klaim tersebut dalam artikel peluncuran pengembang. |
| Berdasarkan uji tolok ukur internal pengembang, skor akurasi model adalah 0,834, melampaui Claude Opus 5 (0,816) dan GPT-5.6 Luna (0,741). | Didukung | “A 2-billion-parameter model scored 0.834, above every frontier configuration we tested, from Claude Opus 5 at 0.816 to GPT-5.6 Luna at 0.741” Hugging Face Blog memuat hasil skor benchmark tersebut. |
| Biaya operasional mandiri di server GPU L40S berkisar 6 hingga 147 kali lebih murah dibanding API komersial. | Didukung | “Cost runs from roughly 6 times lower (GPT-5.6 Luna) to roughly 147 times lower (GPT-5.6 Sol).” Hugging Face Blog membandingkan biaya GPU L40S terhadap model API komersial frontier. |
| Model ini dibangun di atas fondasi DharmaOCR-LITE v1.1 dan dilatih menggunakan adapter LoRA. | Didukung | “The base model is DharmaOCR-LITE v1.1, a new 2-billion-parameter version optimized from the one in the paper and already specialized for OCR through supervised fine-tuning and DPO. On top of that check” Hugging Face Blog mengonfirmasi basis model DharmaOCR-LITE v1.1 dan penggunaan adapter LoRA. |
| Pelatihan model menggunakan 43.384 contoh data dokumen lintas sektor, termasuk kuitansi, faktur komersial, formulir, rekening bank, kartu identitas, dan dokumen sintetis. | Didukung | “On top of that checkpoint we trained a LoRA adapter on 43,384 training examples covering both request modes. The data is organized into three streams: All three streams are annotated at the field level.” Hugging Face Blog menyebutkan jumlah sampel pelatihan 43.384 contoh serta jenis-jenis dokumennya. |
| Uji tolok ukur pengembang dilakukan pada 546 dokumen uji. | Didukung | “The full benchmark covers 546 documents across three request scenarios, for 1,638 total cases” Hugging Face Blog menyatakan benchmark mencakup 546 dokumen. |
| Kutipan pernyataan pengembang: 'Parameter count sets the ceiling; training decides how much of it a model reaches on your task. Your business doesn't need the biggest model available. It needs one trained for your problem.' | Didukung | “Parameter count sets the ceiling; training decides how much of it a model reaches on your task. Your business doesn't need the biggest model available. It needs one trained for your problem.” Kutipan tercantum secara verbatim pada artikel Hugging Face Blog. |
| Model dirancang self-hosted menggunakan satu unit GPU L40S dengan biaya sewa 2,24 dolar AS per jam. | Didukung | “the model runs self-hosted, so the figure is GPU time on a single L40S at $2.24 per hour.” Hugging Face Blog menyebutkan estimasi biaya dihitung dari sewa satu L40S seharga $2,24 per jam. |
Video AI terbaru
Introducing ChatGPT Images 2.6