Riset: AI Sedot Energi hingga 180 Kali Lipat untuk Teks Non-Inggris
Riset Universitas Michigan mengungkap ketimpangan konsumsi daya dan biaya token AI saat memproses bahasa non-Inggris, memicu beban biaya operasional bisnis.
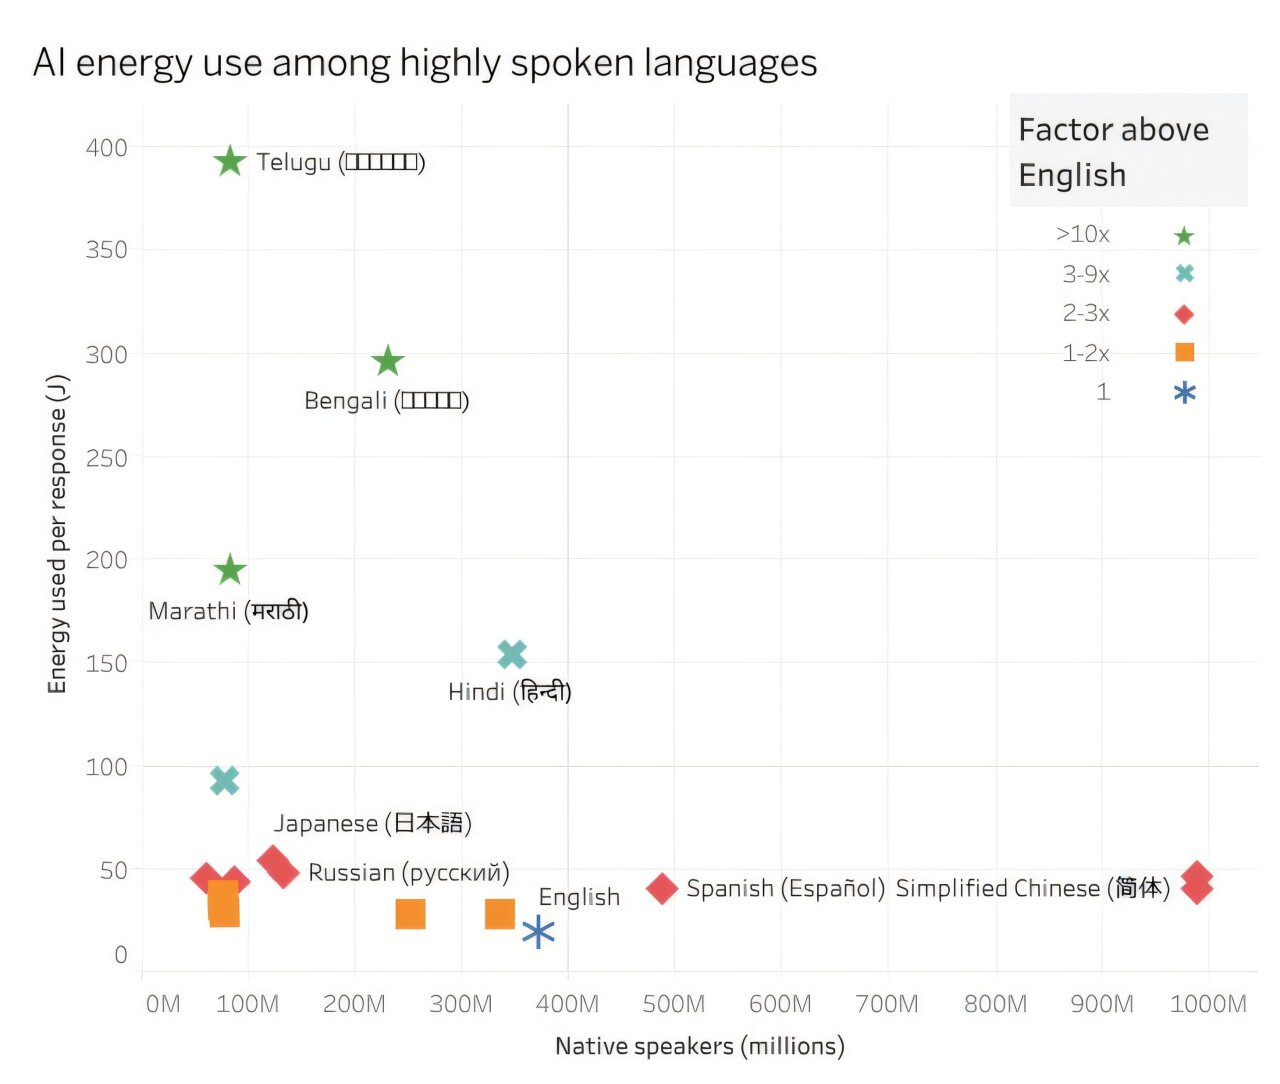
Foto: TechXplore (Dokumentasi editorial)
Poin penting
- AI generatif mengonsumsi daya 1,4 hingga 180 kali lebih besar saat memproses bahasa non-Inggris.
- Beban token membengkak karena tokenisasi karakter non-Latin membutuhkan memori komputasi lebih tinggi.
- Perusahaan diimbau memakai perutean model lokal atau penerjemahan awal guna menekan lonjakan biaya API.
Penggunaan kecerdasan buatan generatif dalam bahasa non-Inggris ternyata memakan daya komputasi dan energi listrik jauh lebih besar. Temuan ini dilaporkan oleh para peneliti University of Michigan Engineering dalam konferensi Empirical Methods in Natural Language Processing (EMNLP) 2026.
Menurut laporan TechXplore, model AI dapat membakar energi 1,4 hingga 180 kali lipat saat menghasilkan teks non-Inggris dibanding teks berbahasa Inggris. Bahasa Eropa Barat rata-rata menghabiskan energi dua kali lipat, sedangkan bahasa Hindi dan Bengali melonjak masing-masing 7,9 dan 15,3 kali lipat.
Mengapa Bahasa Non-Inggris Menyedot Lebih Banyak Biaya
Peneliti menguji tiga model terbuka: Qwen 3 milik Alibaba, Gemma 3 buatan Google, serta Llama 3.1 dari Meta. Pengukuran menggunakan kerangka kerja ML.Energy pada dataset pemahaman bacaan Belebele di 122 bahasa, soal cerita matematika, dan perintah bebas.
Akar persoalan terletak pada sistem token, yaitu potongan data dasar yang dibaca dan diproduksi oleh model AI. Karakter naskah yang kompleks memerlukan lebih banyak potongan token untuk mewakili sebuah kata atau suku kata.
Bahasa yang biasanya mengonsumsi lebih banyak energi juga cenderung memiliki akurasi luaran model yang lebih rendah. Hukuman ganda ini berisiko membuat kelompok tertentu tersingkir dari adopsi AI.
Demikian penjelasan Naihao Deng, mahasiswa doktoral ilmu komputer sekaligus penulis utama riset. Karena memori dipenuhi pecahan token, server harus memproses data dalam kelompok lebih kecil. Akibatnya, pemakaian energi melonjak dan akurasi jawaban kerap menurun.
Apa Artinya bagi Pelaku Usaha
Bagi manajemen dan pengembang teknologi di Indonesia, fenomena fragmentasi token berdampak langsung pada tagihan API model bahasa besar. Sebagian besar penyedia AI mengenakan tarif berbasis jumlah token yang diproses dan dihasilkan, sehingga alur kerja teks non-Inggris otomatis menuntut anggaran lebih tebal.
Untuk memitigasi pembengkakan biaya operasional, tim teknologi dapat mengevaluasi efisiensi tokenizer pada model yang hendak diintegrasikan. Peneliti Universitas Michigan merekomendasikan teknik perutean kueri ke model khusus yang dioptimalkan untuk bahasa lokal, alih-alih terus mengandalkan satu model global berukuran masif.
Langkah alternatif yang layak diuji adalah menerjemahkan kueri pengguna ke dalam bahasa Inggris sebelum diproses oleh model utama, lalu mengembalikan hasilnya. Strategi hibrida ini efektif memangkas volume token sekaligus menjaga akurasi respons sistem layanan pelanggan maupun otomasi operasional bisnis.
- TechXplore: Generative AI uses more energy on non-English text
Lihat hasil pemeriksaan (8 klaim)
| Klaim | Putusan | Dasar di sumber |
|---|---|---|
| AI generatif menyedot energi 1,4 hingga 180 kali lipat lebih besar saat memproses bahasa non-Inggris. | Didukung | “AI models could use 1.4 to 180 times more energy to generate non-English text” TechXplore melaporkan model AI dapat menghabiskan energi 1,4 hingga 180 kali lipat untuk menghasilkan teks non-Inggris. |
| Riset dilakukan oleh peneliti University of Michigan Engineering dan dipresentasikan di konferensi EMNLP 2026. | Didukung | “according to University of Michigan Engineering researchers.” TechXplore menyebut penelitian ini dilakukan peneliti University of Michigan Engineering dan dipresentasikan di EMNLP. |
| Bahasa Eropa Barat menghabiskan energi dua kali lipat atau kurang, sementara Hindi dan Bengali masing-masing membutuhkan 7,9 dan 15,3 kali lipat energi dibandingkan bahasa Inggris. | Didukung | “with most Western European languages coming in at twice the energy expenditure or less. However, responding to prompts in Hindi and Bengali, each spoken by hundreds of millions of people, requires 7.9 and” TechXplore mencantumkan angka perbandingan energi untuk bahasa Eropa Barat serta Hindi (7,9x) dan Bengali (15,3x). |
| Peneliti menguji tiga model terbuka: Qwen 3 Alibaba, Gemma 3 Google, dan Llama 3.1 Meta. | Didukung | “measuring the amount of energy used by three open-source AI models: Alibaba's Qwen 3, Google's Gemma 3 and Meta's Llama 3.1.” TechXplore memuat ketiga model open-source yang diuji oleh para peneliti. |
| Pengukuran menggunakan kerangka kerja ML.Energy pada dataset Belebele di 122 bahasa serta soal matematika dan perintah terbuka. | Didukung | “Belebele , a dataset for assessing the reading comprehension of AI models in 122 different languages. They then measured the amount of energy used to answer each question using the ML.Energy framework” TechXplore memuat pengujian pada Belebele di 122 bahasa dengan ML.Energy framework. |
| Bahasa non-Inggris menyedot energi lebih banyak karena menghasilkan lebih banyak token dan karakter kompleks membutuhkan token lebih banyak sehingga membebani memori. | Didukung | “When working in other languages, the models used more energy because they had to generate more tokens, the basic units of data used by AI.” TechXplore menjelaskan lonjakan energi disebabkan oleh generasi token ekstra pada bahasa non-Inggris. |
| Naihao Deng menyatakan bahasa yang boros energi cenderung memiliki akurasi lebih rendah dan hukuman ganda ini berisiko membuat kelompok tertentu tersingkir dari AI. | Didukung | “"The languages that typically consume more energy also tend to have lower accuracy in the model output," said Naihao Deng, a doctoral student in computer science and engineering from the U-M AI Lab” TechXplore mengutip pernyataan langsung dari Naihao Deng. |
| Peneliti merekomendasikan perutean kueri ke model khusus bahasa atau penerjemahan prompt ke bahasa Inggris sebelum diproses. | Didukung | “This could entail routing user queries to models tailored to specific languages. Companies could also translate user prompts into English before feeding them to a more generalized model” TechXplore memuat dua rekomendasi teknis tersebut untuk memangkas disparitas biaya. |
Video AI terbaru
Washington, D.C. is up next. 🏛️