NVIDIA Rilis 4 Model Terbuka Cosmos 3 untuk Simulasi Robotika dan Otomasi
NVIDIA meluncurkan empat model simulator dunia terbuka Cosmos 3 Nano 16B berlisensi komersial untuk melatih robot dua lengan dan kendaraan otonom secara interaktif.
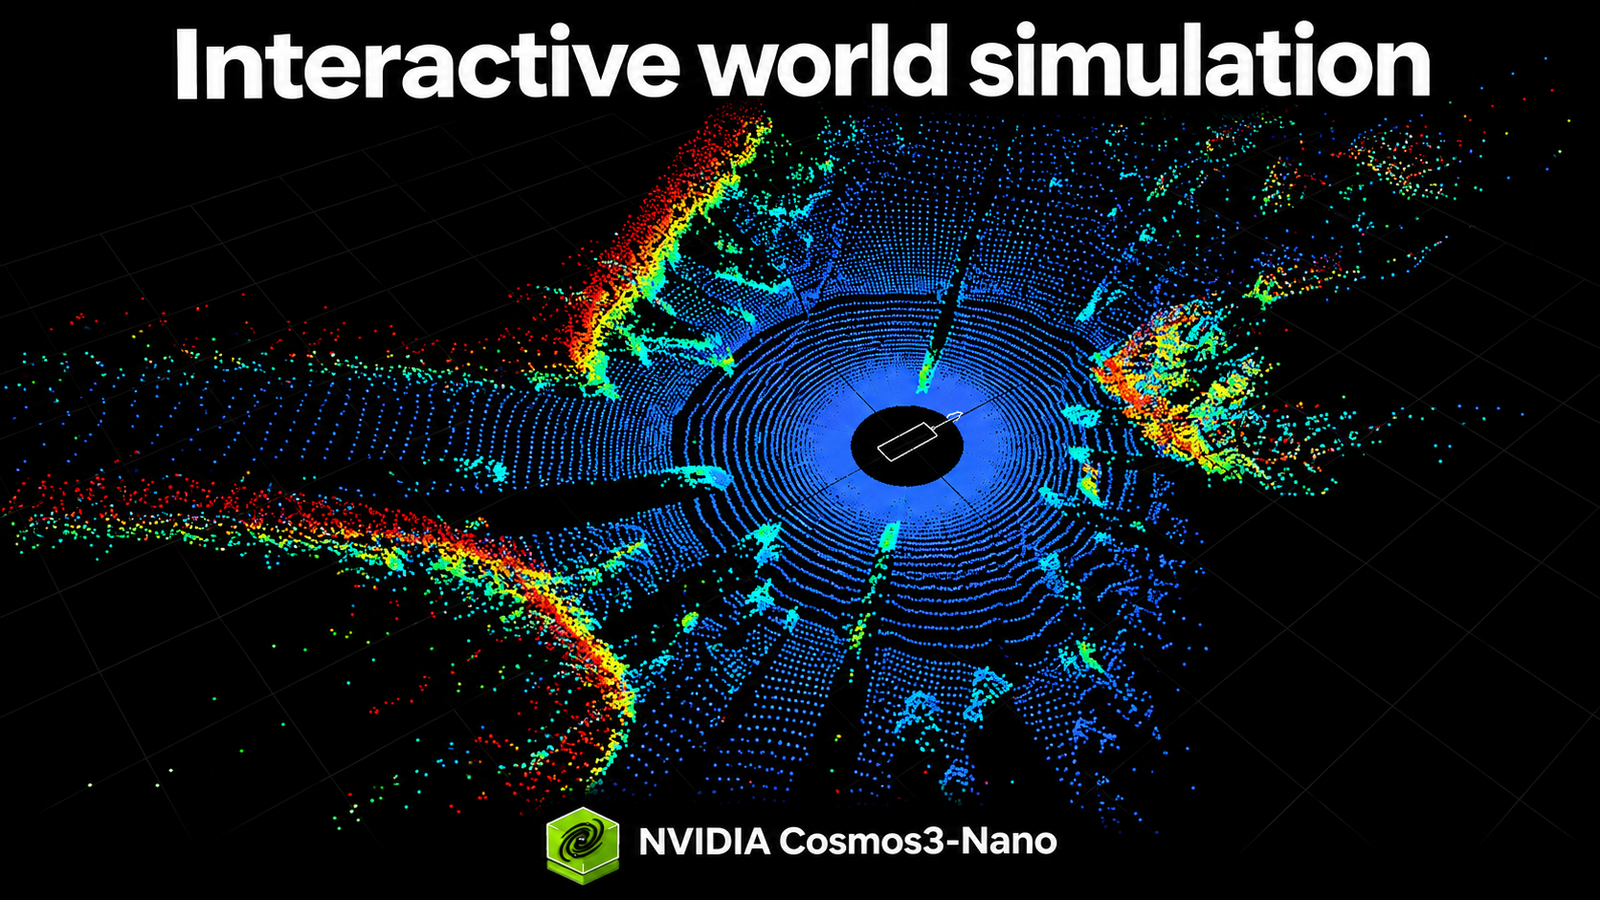
Foto: Hugging Face Blog (Dokumentasi editorial)
Poin penting
- NVIDIA merilis empat model terbuka Cosmos 3 Nano 16B untuk simulasi interaktif dan uji kendara otonom.
- Model menggunakan lisensi OpenMDW1.1 yang mengizinkan pemanfaatan secara komersial maupun non-komersial.
- Tersedia modul khusus untuk robot dua lengan bimanual serta simulasi kamera multi-sudut dan sensor LiDAR.
NVIDIA resmi memperluas ekosistem platform simulasi dunianya dengan meluncurkan empat checkpoint model terbuka (open-weight) baru pada keluarga Cosmos 3. Berdasarkan laporan di laman resmi Hugging Face Blog, keempat model tersebut dirancang untuk menghasilkan simulasi interaktif lingkungan fisik dan skenario berkendara multi-sensor.
Keempat model ini merupakan hasil pelatihan lanjutan (post-training) dari Cosmos 3 Nano dengan ukuran 16 miliar (16B) parameter yang dapat dilatih. NVIDIA merilis bobot model ini menggunakan lisensi OpenMDW1.1, yang secara resmi mengizinkan penggunaan komersial maupun non-komersial sesuai ketentuan yang berlaku.
Empat Checkpoint untuk Navigasi dan Robotika
Untuk sektor mobilitas cerdas, NVIDIA menghadirkan Cosmos3-Nano-Transfer-Auto dan Sim-Auto. Transfer-Auto berfungsi menghasilkan data sintetis berkendara multi-sensor secara luring (offline), dengan dukungan sinkronisasi hingga 11 sudut pandang kamera dan sensor LiDAR (teknologi pemindai jarak berbasis laser).
Sementara itu, Sim-Auto adalah varian hasil distilasi kausal yang mampu menghasilkan aliran video dan data sensor secara langsung (streaming). Model ini memungkinkan pengembang menguji kebijakan kemudi otonom dalam siklus interaksi tertutup dengan beberapa langkah penghilangan derau (denoising steps).
Dua varian lainnya difokuskan pada manipulasi fisik. Sim-Transfer menerjemahkan data spasial simulator fisika—seperti kedalaman dan segmentasi objek—menjadi tampilan visual RGB. Di sisi lain, Sim-Bimanual memprediksi konsekuensi visual langsung dari aksi robot dua lengan, seperti pada platform YAM dan AgiBot.
Arsitektur Streaming dan Kebutuhan Sistem
Teknologi di balik Cosmos 3 mengandalkan arsitektur Mixture-of-Transformers yang memproses representasi video terkompresi (latents), di mana satu langkah waktu mewakili empat bingkai gambar RGB. Pelatihan model ini melalui empat tahap, berpuncak pada teknik self-forcing agar akumulasi kesalahan prediksi visual tidak merusak jalannya simulasi jangka panjang.
Untuk menjalankan inferensi, pengembang membutuhkan sistem operasi Linux, kartu grafis (GPU) NVIDIA, Docker, serta NVIDIA Container Toolkit. Dalam laporan teknisnya, konfigurasi server vLLM-Omni diuji menggunakan infrastruktur chip NVIDIA GB200.
Apa Artinya bagi Pelaku Usaha
Kehadiran model berlisensi komersial ini memangkas biaya mahal pengumpulan data fisik bagi pelaku usaha di sektor logistik, manufaktur, dan transportasi. Perusahaan kini dapat melatih algoritma robotika dan sistem navigasi otonom di lingkungan digital yang aman tanpa perlu mengerahkan armada uji coba nyata berisiko tinggi.
Sebelum berinvestasi penuh, para pimpinan teknologi disarankan mengevaluasi kesiapan infrastruktur komputasi internal. Mengingat beban komputasi model 16B parameter cukup intensif, uji coba awal sebaiknya dilakukan lewat komputasi awan (cloud) sewa berbasis GPU sebelum membangun fasilitas server mandiri.
Langkah mitigasi berikutnya adalah memvalidasi kualitas simulasi menggunakan skenario lokal sebelum menerapkannya ke lini produksi fisik. Pemanfaatan model simulasi dunia seperti Sim-Bimanual dapat menjadi panduan awal untuk menguji keselamatan kerja dan efisiensi lini perakitan pabrik sebelum perangkat keras robot benar-benar dibeli.
- Hugging Face Blog: New NVIDIA Cosmos 3 Open Models for Interactive World Simulation
Lihat hasil pemeriksaan (10 klaim)
| Klaim | Putusan | Dasar di sumber |
|---|---|---|
| NVIDIA merilis empat checkpoint model terbuka (open-weight) baru pada lini Cosmos 3 untuk simulasi interaktif. | Didukung | “NVIDIA Cosmos world model development platform adds four new open-weight checkpoints to its Cosmos 3 model family for generating interactive world simulation” Hugging Face Blog |
| Keempat model merupakan hasil post-training dari Cosmos 3 Nano dan memiliki 16 miliar (16B) parameter yang dapat dilatih. | Didukung | “All four models are post-trained examples of Cosmos 3 Nano and have 16B trainable parameters.” Hugging Face Blog |
| Model dirilis dengan lisensi OpenMDW1.1 yang mengizinkan pemanfaatan komersial dan non-komersial. | Didukung | “The models use OpenMDW1.1, permitting commercial and non-commercial use under its terms.” Hugging Face Blog |
| Cosmos3-Nano-Transfer-Auto mendukung pembuatan data sintetis mengemudi luring dengan sinkronisasi hingga 11 sudut pandang kamera dan sensor LiDAR. | Didukung | “It generates synchronized video across up to 11 camera views, including fisheyes, and supports joint RGB–LiDAR generation.” Hugging Face Blog |
| Cosmos3-Nano-Sim-Auto merupakan varian streaming hasil distilasi kausal dari Transfer-Auto dengan beberapa langkah denoising. | Didukung | “Cosmos3-Nano-Sim-Auto is the causally distilled streaming variant of Transfer-Auto. It generates successive small chunks of synchronized camera video and LiDAR in just a few denoising steps” Hugging Face Blog |
| Sim-Transfer mengubah kontrol spasial simulator fisika menjadi observasi gambar berwarna (RGB). | Didukung | “Sim-Transfer uses its spatial controls and a text prompt to render color observations that a policy can consume.” Hugging Face Blog |
| Sim-Bimanual menyimulasikan aksi robot dua lengan untuk platform YAM dan AgiBot. | Didukung | “It supports interactive two-arm simulation for YAM and AgiBot embodiments, controlled by a policy or human-operated joysticks.” Hugging Face Blog |
| Arsitektur Cosmos 3 menggunakan Mixture-of-Transformers dan tiap langkah waktu laten mewakili empat bingkai RGB. | Didukung | “Cosmos 3’s Mixture-of-Transformers backbone connects separate text-processing and visual-generation networks through attention.” Hugging Face Blog |
| Pelatihan model mencakup tahap self-forcing untuk mengatasi penumpukan kesalahan prediksi visual. | Didukung | “Why the final stage matters: a slightly mispredicted object becomes context for later frames, so errors can compound. Self-forcing exposes training to that generated history.” Hugging Face Blog |
| Kebutuhan sistem mencakup Linux, GPU NVIDIA, Docker, NVIDIA Container Toolkit, dan setup vLLM-Omni diuji pada satu chip GB200. | Didukung | “Requirements: Linux, an NVIDIA GPU, Docker, and NVIDIA Container Toolkit. The published vLLM-Omni setup was tested on one GB200” Hugging Face Blog |
Video AI terbaru
Washington, D.C. is up next. 🏛️